YOLO op een embedded device
Objectdetectie op een embedded device is vandaag verrassend haalbaar. Toch is het YOLO-model laten draaien maar een klein deel van het werk. In een echt product moeten de camera-input, de videoconversie, de inference, de rendering, de streaming, de applicatielogica en de deployment samen efficiënt en betrouwbaar werken. Hieronder lopen we die keten door, van camerabeeld tot een vision pipeline die je met GStreamer, hardware-acceleratie en Yocto Linux in productie kunt nemen.
YOLO hoeft niet meer in de cloud te draaien
YOLO (You Only Look Once) is een familie van neurale netwerken voor objectdetectie. Door kleinere modelvarianten, quantisatie en gespecialiseerde accelerators kun je zulke modellen vandaag lokaal draaien op een embedded Linux-systeem. Daarmee worden toepassingen mogelijk zoals objectdetectie, kwaliteitscontrole, people counting, voertuigdetectie en machine vision, zonder dat je elk videoframe naar de cloud moet sturen.
Of een processor YOLO kan uitvoeren, is daarbij niet de vraag die ertoe doet. Het product moet de volledige keten aankunnen binnen het beschikbare budget voor vermogen, warmte en latency.
De vraag is dus of het volledige vision-systeem de vereiste resolutie, latency en framerate haalt.
Waarom inference aan de edge?
- Lagere latency. Het toestel neemt beslissingen lokaal, zonder roundtrip over het netwerk.
- Privacy. De ruwe videobeelden hoeven het toestel niet te verlaten.
- Minder bandbreedte. Vaak volstaan events, tellingen of metadata in plaats van een continue videostroom.
- Offline werking. De toepassing blijft werken zonder internetverbinding.
- Een voorspelbare operationele kost. De inference gebeurt op het toestel zelf.
Edge inference is ook niet altijd de beste oplossing. Heb je zeer zware modellen nodig, moeten de beelden sowieso centraal verwerkt worden, of spelen latency en privacy weinig mee, dan is inference in de cloud soms eenvoudiger. Vertrek dus vanuit de toepassing.
CPU, GPU en NPU: kijk verder dan TOPS
Embedded platformen combineren steeds vaker gewone CPU-cores met een GPU, een NPU of een andere accelerator. Een i.MX8M Plus is bijvoorbeeld interessant voor compacte vision-toepassingen omdat hij naast de Cortex-A53 CPU een NPU heeft. Andere platformen, zoals NVIDIA Jetson en systemen op basis van Rockchip, Qualcomm of Intel, hebben hun eigen accelerators en runtimes.
Een theoretisch acceleratorcijfer vertelt maar een deel van het verhaal. Cameracapture, decoding, scaling, colorspace-conversie, de voorbereiding van de tensor, post-processing en rendering bepalen samen minstens even sterk de totale latency.
GStreamer als ruggengraat van de videopipeline
In veel AI-demo’s gaat alle aandacht naar het neurale netwerk. In productie is de videopipeline minstens even belangrijk, en op embedded Linux is GStreamer daar bijzonder geschikt voor. Je bouwt er capture, decoding, conversie, filtering, encoding, streaming en de integratie met je applicatie mee op als één pipeline.
Camera | vGStreamer capture / decode / resize | +----> YOLO inference ----> detections / events | +----> display / Qt HMI | +----> H.264/H.265 encoder ----> stream or recordingAfhankelijk van het platform gebruikt GStreamer V4L2, hardwaredecoders, hardwareconverters en platformspecifieke plugins. Met een element als tee stuur je dezelfde bron efficiënt naar verschillende verwerkingspaden. Via appsink en appsrc integreer je eigen C/C++-code wanneer de inference of de applicatielogica buiten de pipeline gebeurt.
De verborgen bottleneck: memory copies
Een snelle NPU maakt een inefficiënte datapipeline niet vanzelf goed. Een naïeve implementatie kopieert en converteert een cameraframe soms meerdere keren voor het als tensor bij de accelerator aankomt.
Camera buffer | +-- copy --> GStreamer buffer | +-- copy --> OpenCV Mat | +-- convert --> RGB | +-- copy --> tensor | v NPUOp embedded hardware kost elke kopie CPU-tijd en geheugenbandbreedte. In een goede architectuur blijven frames daarom zo lang mogelijk in buffers waar de hardware rechtstreeks mee overweg kan. DMA/DMABUF, hardware scaling en GStreamer-plugins die specifiek voor de accelerator gemaakt zijn, helpen daarbij. Of je echt zero-copy haalt, hangt wel sterk af van het platform en de drivers, en dat moet je in de concrete implementatie nagaan.
Waar OpenCV past
OpenCV blijft een uitstekende toolbox voor klassieke computer vision, beeldbewerking en geometrische operaties. Het hoeft alleen niet de volledige videopipeline te beheren. Op embedded is het vaak efficiënter om capture, decoding en conversie aan GStreamer en de hardware-accelerators over te laten, en OpenCV enkel in te zetten waar het echt iets toevoegt.
Camera --> GStreamer --> hardware resize/convert --> appsink --> YOLO / OpenCVHet model is een systeemparameter
Welk YOLO-model je kiest, heeft invloed op de accuracy, de latency, het geheugengebruik en het vermogensverbruik. Kleinere nano- of small-varianten passen vaak veel beter bij een embedded toepassing dan een groter model dat maar weinig kwaliteit wint. Een paar vuistregels:
- Kies de inputresolutie op basis van de kleinste objecten die je betrouwbaar moet detecteren.
- Meet de volledige end-to-end latency en niet alleen de inference-tijd.
- Bekijk quantisatie, bijvoorbeeld naar INT8, als de accelerator dat efficiënt ondersteunt.
- Bepaal hoeveel inference-frames per seconde de toepassing echt nodig heeft.
- Valideer de accuracy opnieuw na elke modelconversie of quantisatie.
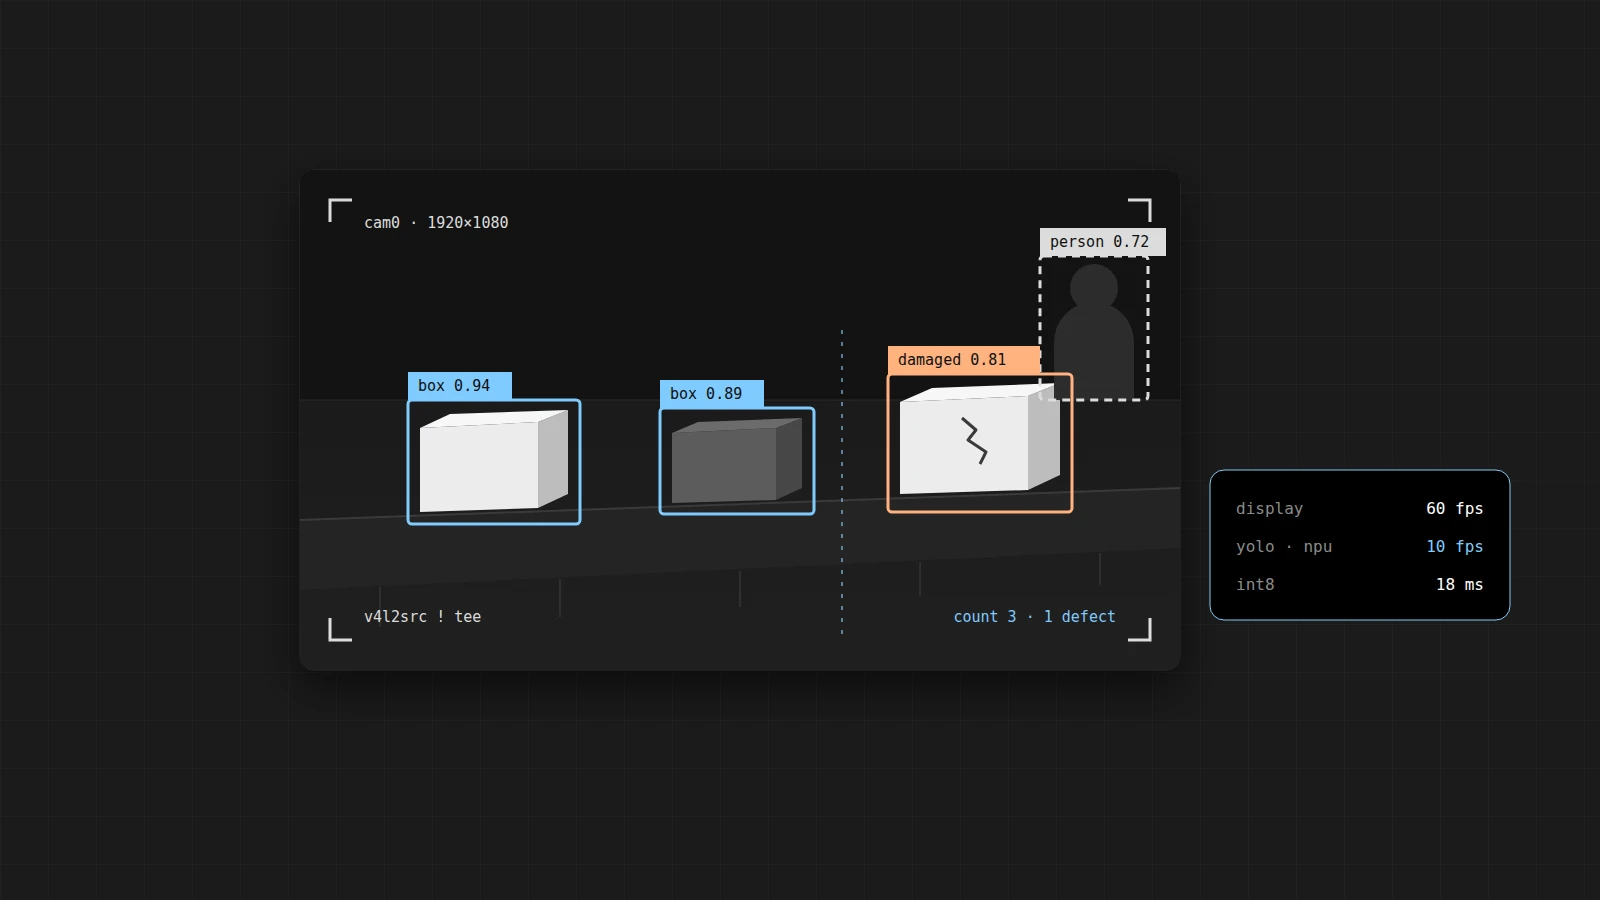
Een belangrijke optimalisatie is dat de videoweergave en de inference niet aan dezelfde framerate hoeven te draaien. Een HMI kan vloeiend 30 of 60 fps tonen terwijl YOLO maar 5 of 10 frames per seconde analyseert.
+----> Display @ 60 fpsCamera --> tee --+ +----> YOLO @ 10 fpsInference runtimes en hardware-acceleratie
Het YOLO-model en de runtime die het op het toestel uitvoert, zijn twee verschillende dingen. Afhankelijk van het platform draait je deployment op ONNX Runtime, TensorRT, TensorFlow Lite, OpenVINO of een NPU-runtime van de leverancier. Modelconversie en quantisatie horen daardoor bij de keuze van het platform.
Welke combinatie het best werkt, hangt af van de modellen die je wilt gebruiken, de ondersteunde operators, de beschikbare precisies, de tooling, de BSP-ondersteuning en hoe volwassen de software van de accelerator is. Een snelle accelerator met een softwarestack die moeilijk te onderhouden is, kan in een industrieel product alsnog de verkeerde keuze zijn.
Van bounding boxes naar een echt product
Een proof-of-concept stopt vaak zodra er bounding boxes op het beeld verschijnen. Voor een product begint het werk dan pas, want de detecties moeten nog vertaald worden naar betrouwbare applicatielogica.
Camera --> GStreamer --> YOLO --> tracking / filtering --> application logic | +--> Qt HMI +--> MQTT / REST +--> local recording +--> cloud / telemetryDaar komt onder meer het volgende bij kijken:
- False positives wegfilteren en confidence thresholds instellen.
- Zones of interest en regels die specifiek zijn voor de toepassing.
- Object tracking met persistente ID’s.
- Events genereren in plaats van ruwe detecties door te geven.
- Lokale logging en diagnostiek.
- Integratie met de machinebesturing, de HMI of de cloud.
- Beheer van zowel de software- als de modelversies.
Qt/QML, GStreamer en YOLO
In industriële toepassingen zie je vaak een live camerabeeld met grafische overlays. De UI hoeft daarvoor niet zelf elk frame door het model te sturen, want de videopipeline en de inferencepipeline kunnen los van elkaar werken.
Camera |GStreamer +--------------------> Qt / QML video output | +----> YOLO ----> bounding boxes / classes / tracking IDs | v QML overlayDe UI krijgt dan vooral detectieresultaten binnen: coördinaten, classes, confidence en eventueel tracking ID’s. Zo blijven de verantwoordelijkheden gescheiden, en de architectuur schaalt en laat zich beter testen.
Yocto: van demo naar reproduceerbaar product
Een Python-demo op een development board is nog geen productieplatform. Voor een industrieel toestel moet je de volledige softwarestack reproduceerbaar kunnen bouwen, onderhouden en updaten. Yocto is daar vaak een logische keuze voor, zeker als de hardwareleverancier zijn BSP en de ondersteuning voor de accelerator als Yocto-layers aanbiedt. Waarom we voor zo’n product meestal bij Yocto uitkomen, lees je in Yocto vs Ubuntu vs Debian.
Application / Qt HMIYOLO modelGStreamer + pluginsInference runtimeDevice services-------------------------Custom Yocto Linux image-------------------------Embedded hardwareIn het image of het updateproces moeten dan onder meer de juiste GStreamer-plugins, kernel- en cameradrivers, de runtime van de accelerator, de modelbestanden en de applicatiecomponenten zitten. De software en de AI-modellen hebben bovendien elk hun eigen versie- en lifecyclebeheer.
Kies de hardware vanuit de toepassing
Een embedded vision-platform kies je beter niet op basis van een processorbenchmark. Begin bij de use case en bepaal per onderdeel wat het product nodig heeft.
| Onderdeel | Wat moet je bepalen? |
|---|---|
| Camera | Resolutie, aantal camera’s, interface, sensorformaat en framerate |
| Vision | Objectgrootte, accuracy, modelklasse en de vereiste inference-rate |
| HMI | Live video, overlays, displayresolutie en de gewenste UI-framerate |
| Video-output | Alleen events, of ook encoding, recording en streaming? |
| Platform | Thermisch budget, fanless ontwerp, voeding en beschikbare interfaces |
| Lifecycle | BSP-ondersteuning, security-updates, model- en software-updates |
Tot slot
YOLO op een embedded device laten draaien is relatief eenvoudig. Er een betrouwbaar vision-product rond bouwen, daar zit het eigenlijke engineeringwerk. Het model is maar één component. De camera-interfaces, de GStreamer-pipelines, de hardware-acceleratie, de geheugenbandbreedte, de inference runtimes, de applicatielogica, de HMI-software en het embedded Linux-platform moet je als één systeem ontwerpen.
Bij Invisto bekijken we embedded vision daarom van begin tot eind: van de embedded hardware en een custom Yocto Linux tot de GStreamer-pipelines, de AI-inference, Qt/QML-HMI’s en de cloudconnectiviteit. Zo groeit een werkend AI-experiment uit tot een industrieel product dat je kunt onderhouden.